从数据工作流到数据服务 互联网数据体系的演进与实践
在数字经济时代,数据已成为核心生产要素,而互联网数据工作流与数据服务则是释放数据价值的两大关键支柱。前者关注数据从产生到消费的全链路流转效率,后者则着眼于如何将数据以标准化、可复用的方式赋能业务。理解二者的内在联系与协同逻辑,对于构建敏捷、可靠的数据体系至关重要。
一、互联网数据工作流:数据价值的流水线
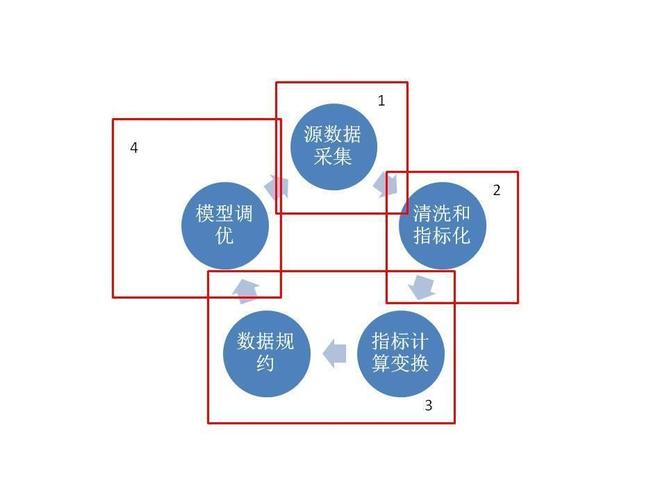
互联网数据工作流是指对数据从采集、传输、存储、处理到应用的全生命周期进行编排与管理的系统性过程。其核心在于")可用"与"高效"。典型的工作流通常包括:数据采集(日志埋点、API接口、数据库同步)、数据清洗与转换(ETL/ELT)、数据存储(数据湖、数据仓库)、数据计算(批处理、流处理)以及数据可视化与下发。与传统的单点工具不同,现代数据工作流强调自动化调度、依赖管理与质量监控。例如,基于有向无环图(DAG)的任务编排工具(如Apache Airflow)让不同计算任务按照依赖关系有序执行;数据质量校验节点被嵌入流水线中,确保异常数据不向下游扩散。互联网业务的高并发、多源异构特性,还要求工作流具备弹性伸缩和容错能力,以应对流量洪峰和节点故障。只有建成稳定、可观测的工作流,数据才能持续、可靠地流转。
二、互联网数据服务:让数据"即取即用"
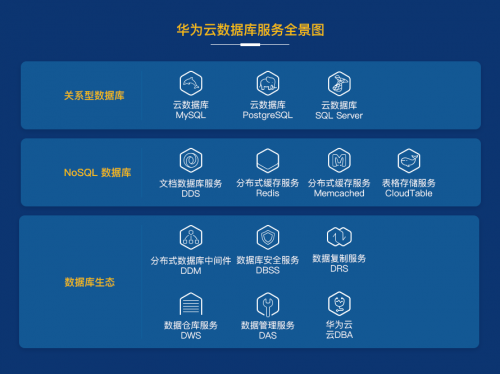
数据服务是数据工作流的下游延伸,它将加工后的数据封装成标准化的接口或产品,供业务方按需调用。与直接开放数据库或数据表不同,数据服务通过API网关、数据订阅或指标平台等方式,提供权限可控、口径统一、性能保障的数据访问能力。典型的数据服务包括:基础画像服务(用户标签查询)、实时指标服务(如交易风控所需的实时特征)、分析报表服务以及数据推送服务。数据服务的核心价值在于"收敛与复用"——将分散在数仓中的逻辑收敛为统一的服务口径,避免各业务重复开发;同时通过服务编排、缓存与限流等手段,保障高并发下的稳定响应。在微服务架构盛行的互联网场景下,数据服务是数据中台对外输出的主要形态,业务系统通过调用数据服务快速获得数据能力,而无需理解底层工作流的复杂细节。
三、工作流与服务的协同:形成闭环
数据工作流与数据服务并非孤立存在,而是构成"生产—消费—反馈"的闭环。一方面,工作流产出的高质量数据是数据服务的基石;没有稳定的离线与实时链路,服务响应便会失去可信的数据源。另一方面,数据服务的运行指标(如调用频次、响应时延、业务转化效果)又可回流至工作流监控体系,帮助发现数据链路中的瓶颈与异常,反哺工作流优化。例如,某数据API调用量骤增,可能触发工作流扩容;某一数据集服务输出错误率上升,则需回溯工作流的清洗逻辑。这种协同要求组织在工具层面打通调度系统与服务网关,在治理层面建立统一的元数据管理与血缘追踪,才能在出现问题时快速定位是工作流侧的时延还是服务侧的过载。
四、实践建议与趋势展望
要构建健康的互联网数据工作权与服务生态,企业应从三个方面入手:其一,强化数据工作流的测试与监控,让数据质量成为自动化的门禁项;其二,推行数据服务的契约化管理,明确接口SLA与版本兼容规范;其三,建立端到端的数据可观测性,实现从原始日志到服务响应的血缘穿透。随着AI与实时计算的发展,数据工作流正走向智能化编排(如基于负载预测的资源调度),数据服务也在向向量化检索、对话式查询等新形态演进。二者的融合将更加紧密,最终让数据像水电一样,随用随取、高效流动,成为业务创新的真正生产力。
如若转载,请注明出处:http://www.zghtsle.com/product/21.html
更新时间:2026-10-30 17:41:12